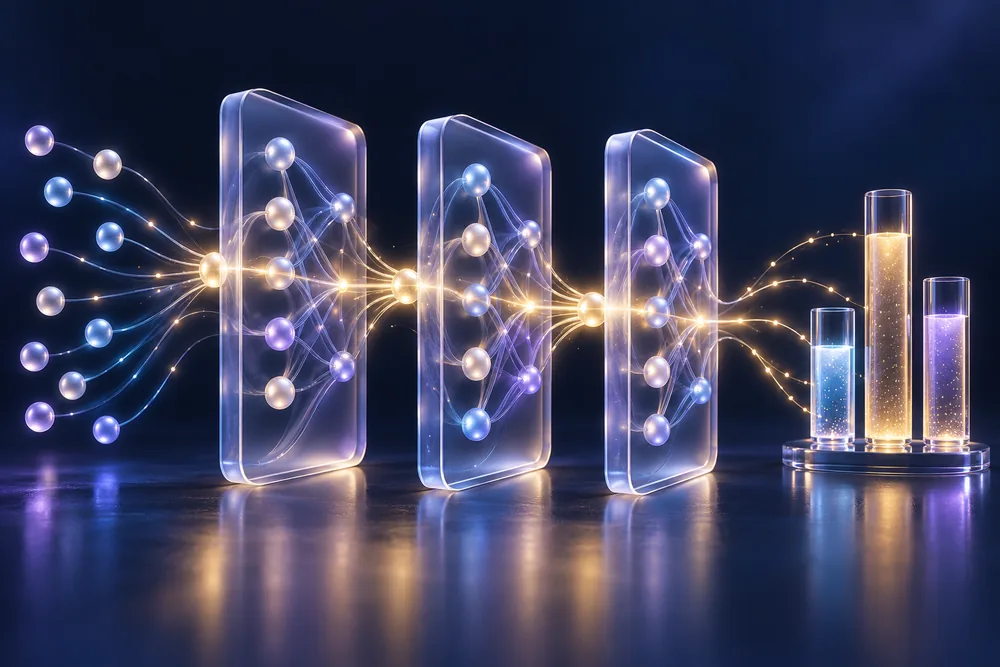
- 解释什么是前向传播
- 区分类别分数与概率
- 正确理解模型的一次预测
延续手写数字场景
给模型一张新图片,会发生什么?
先转换为与训练时一致的数值。
信息从前向后逐层计算。
当前分数最高的候选答案。
预测只使用当前参数计算结果;没有答案对比,也不修改参数。第 04、05 课才会进入“发现错误并更新参数”的训练过程。
输入必须遵守约定
模型不会自动理解任意格式的数据
- 统一形状
例如把数字图片处理成固定宽高,并保持像素排列顺序。
- 统一范围
如果训练时像素缩放到 0–1,预测时也要做同样缩放。
- 组成一批
即使只有一张图片,框架通常也会保留“批次”这一维。
- 交给同一模型
使用训练完成并正确加载的网络结构与参数。
模型表现突然变差时,先检查输入处理是否与训练一致,再判断是不是模型能力不足。
互动实验 · 前向传播
逐层查看一组数值怎样变成预测
笔画较亮,重心接近中央,上下结构较对称。
输入
先把输入整理成训练时约定的数值形式。真实图像模型通常直接处理大量像素或特征图。
实验参数固定,数值由页面中的真实计算产生,但这是教学网络,不代表课程 01 的数字识别模型,也不用于评估真实准确率。
把重复计算写得更紧凑
一层其实在同时计算许多神经元
[0.85, 0.72, 0.91]3 个输入数值3 行 × 3 列3 个神经元各有 3 个权重[−0.20, 0.05, −0.35]每个神经元一个偏置[1.00, 0.92, 0.95]经过 ReLU 的输出整层写法h = ReLU(xW + b)
它只是把许多神经元的重复计算整理在一起。理解“每个输出都是输入的加权组合”,就已经抓住核心。
从 logits 到相对概率
原始分数还不能直接叫概率
温度较低时差距被放大,温度较高时分布更平缓。最高类别在本例中没有改变,但概率数值发生了变化。
用于比较的模型输出
可以为负数,也不需要落在 0–1。
候选类别间的相对分配
总和为 1,便于排序与展示。
选择最大值的位置
分类任务中常用 argmax 选择最高的一项。
结果需要被正确解释
高概率不等于一定正确
适合必须给出单一答案的场景,但要同时考虑出错成本。
可用于搜索、推荐或人工复核,避免过早丢掉合理选项。
把低信心结果交给人工或其他规则,门槛需用验证数据确定。
一次输出的 80% 不是“模型整体准确率为 80%”。整体表现要在有代表性的测试集上统计;概率是否可信,还需要单独检查校准情况。
可选代码实践
用 NumPy 表达一次前向传播
import numpy as np

x = np.array([0.85, 0.72, 0.91])
W1 = np.array([[0.9, -0.2, 0.4],
               [-0.3, 1.1, 0.2],
               [0.7, 0.3, 0.9]])
b1 = np.array([-0.2, 0.05, -0.35])
W2 = np.array([[0.5, 0.7, -0.1],
               [-0.4, 0.4, 0.8],
               [-0.2, 0.9, 0.25]])
b2 = np.array([0.0, 0.15, 0.0])
h = np.maximum(0, x @ W1 + b1)
logits = h @ W2 + b2
probs = np.exp(logits - logits.max())
probs = probs / probs.sum()
print(dict(zip(["3", "8", "9"], probs.round(3))))- x
保存已经整理好的输入。
- W1、W2 与偏置
两组数组保存隐藏层和输出层已经训练好的参数。
- x @ W1 + b1
@ 表示矩阵乘法,完成隐藏层所有神经元的加权求和。
- np.maximum
逐项应用 ReLU,把负数变为 0。
- 最后两行
先计算指数,再除以总和,得到 Softmax 概率。减去最大值可让计算更稳定。
这段代码可以直接运行;它只演示一次预测,不包含读取图片或训练参数。第 15 课会在完整项目中串起全部流程。
知识检查与阶段总结
第一阶段,到这里形成闭环
已回答 0 / 3 题 · 当前答对 0 题
- 预测前,输入处理必须与训练时保持一致。
- 前向传播按当前权重和偏置逐层计算,不更新参数。
- 隐藏层重新组合数值,输出层产生类别原始分数。
- Softmax 把 logits 转成相加为 1 的相对概率。
- 一次高概率输出仍可能出错,需要用真实数据评估。
下一课 · COURSE 04
损失函数与梯度下降
从一次预测继续前进:衡量错误,再沿着减少错误的方向调整参数。
第二阶段 · 第 1 课